
Árboles de Decisión: De Preguntas Simples a Divisiones Matemáticas
Aprende cómo un algoritmo divide el espacio de datos en ramas lógicas usando la impureza de Gini y la ganancia de información (Information Gain) para clasificar y predecir.
¿Quieres seguir con el dedo las preguntas de un árbol real?
Nuestro simulador muestra, paso a paso, las preguntas sí/no que un árbol de profundidad 5 se hace para tasar tu departamento en Lima.
01¿Qué es un Árbol de Decisión?
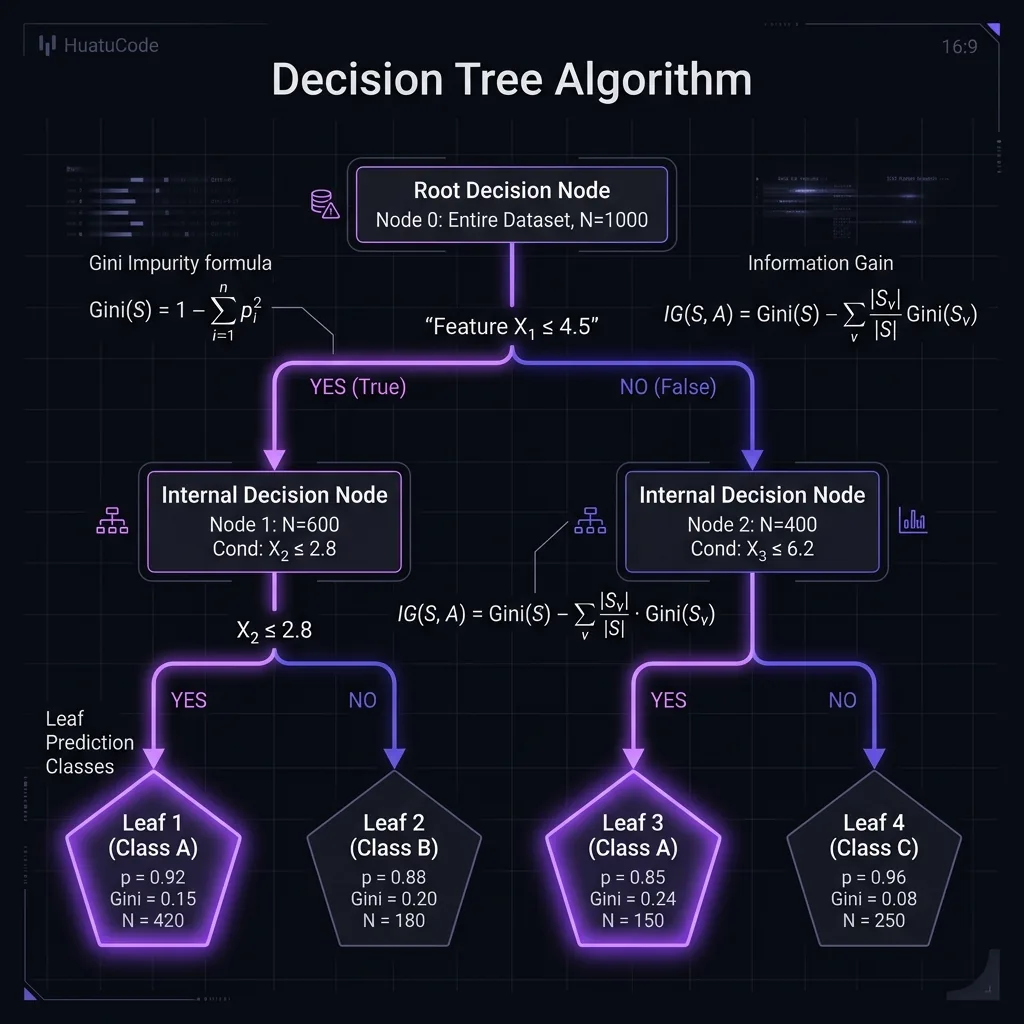
Un Árbol de Decisión es un modelo de aprendizaje supervisado no paramétrico que particiona recursivamente el espacio de características mediante reglas ortogonales condicionales (si X₁ ≤ umbral entonces ir a la izquierda, sino a la derecha).
A diferencia de los modelos basados en planos geométricos o pesos opacos, los árboles son modelos de caja blanca (white-box): cada predicción puede trazarse y auditarse visualmente desde el nodo raíz hasta la hoja terminal como si fuera un diagrama de flujo de lógica pura.
02Criterios de Partición: Impureza de Gini vs Entropía
En cada nodo, el algoritmo busca la variable y el umbral que maximicen la pureza de las divisiones resultantes. El criterio estándar en Scikit-Learn (algoritmo CART) es la Impureza de Gini:
Impureza de Gini = 0.0
Nodo perfectamente puro: el 100% de las muestras en ese subconjunto pertenecen a una sola clase. No se requieren más divisiones.
Ganancia de Información (Gain)
Es la reducción de impureza conseguida tras la división: Gain = Gini(Padre) - ∑ (N_hijo / N_padre) · Gini(Hijo).
03El Talón de Aquiles: Sobreajuste (Overfitting) y Poda
Si no se le imponen restricciones, un árbol de decisión crecerá hasta que cada hoja contenga exactamente 1 muestra, alcanzando 100% de precisión en entrenamiento pero fallando estrepitosamente en datos nuevos.
- max_depth: Limita la altura máxima del árbol (evita reglas hiperespecíficas).
- min_samples_split: Cantidad mínima de muestras requeridas para intentar una división.
- min_samples_leaf: Mínimo de observaciones obligatorias en cada nodo terminal.
04Estrategias de Poda: Pre-Pruning vs Post-Pruning
Para controlar la tendencia destructiva del árbol hacia el sobreajuste (memorizar hojas con 1 sola muestra), aplicamos dos filosofías de regularización:
Pre-Poda (Early Stopping)
Frena el crecimiento del árbol antes de completarse fijando topes como max_depth=4 o exigiendo un mínimo de muestras por hoja min_samples_leaf=10. Rápido y fácil de sintonizar.
Post-Poda (Cost-Complexity Pruning)
Permite que el árbol crezca a profundidad completa y luego recorta recursivamente las ramas que aporten menor ganancia usando el parámetro de complejidad ccp_alpha.
05¿En qué situaciones conviene utilizar Árboles de Decisión?
Un Árbol de Decisión individual no es el modelo más potente del mundo moderno, pero es la herramienta rey indiscutida cuando se requiere comunicación y trazabilidad visual.
- Protocolos de Triaje y Flujos de Decisión Humana:
En emergencias médicas hospitalarias, manuales de soporte técnico o aprobación de préstamos en ventanilla, se requiere un diagrama de flujo transparente que un operador humano pueda memorizar o imprimir en una hoja.
- Datos heterogéneos sin escalado previo:
Permite mezclar características numéricas continuas (ingresos en millones), variables discretas (edad en años) y categóricas sin necesidad de normalizar ni estandarizar escalas.
- Exploración preliminar de interacciones:
Permiten descubrir de un vistazo qué variables interactúan entre sí y cuáles son los umbrales de corte naturales del negocio antes de construir modelos más complejos.
- Competencias y Producción de Alta Precisión:
En datasets tabulares reales, un árbol individual casi siempre es superado por ensambles como Random Forest o XGBoost, que eliminan su varianza inherente.
- Inestabilidad estructural ante pequeñas variaciones:
Un árbol individual sufre de altísima sensibilidad al azar; cambiar solo 10 filas en el dataset de entrenamiento puede cambiar la raíz y generar un árbol con estructura totalmente distinta.
- Fronteras diagonales suaves:
Al particionar únicamente mediante cortes perpendiculares a los ejes (X_i ≤ c), para modelar una relación lineal diagonal suave y = x el árbol se ve obligado a crear una escalera infinita de micro-escalones ortogonales.
06Código Reproducible en Python
# 1. Cálculo de Impureza de Gini y división óptima desde cero
import numpy as np

def gini_impurity(y):
    classes, counts = np.unique(y, return_counts=True)
    probabilities = counts / len(y)
    return 1.0 - np.sum(probabilities ** 2)

def best_split(X, y):
    best_gain = -1.0
    split_idx, split_threshold = None, None
    current_gini = gini_impurity(y)

    n_samples, n_features = X.shape
    for feat_idx in range(n_features):
        thresholds = np.unique(X[:, feat_idx])
        for thresh in thresholds:
            left_mask = X[:, feat_idx] <= thresh
            right_mask = ~left_mask

            if np.sum(left_mask) == 0 or np.sum(right_mask) == 0:
                continue

            n_l, n_r = np.sum(left_mask), np.sum(right_mask)
            gini_l = gini_impurity(y[left_mask])
            gini_r = gini_impurity(y[right_mask])
            child_gini = (n_l / n_samples) * gini_l + (n_r / n_samples) * gini_r

            info_gain = current_gini - child_gini
            if info_gain > best_gain:
                best_gain = info_gain
                split_idx = feat_idx
                split_threshold = thresh

    return split_idx, split_threshold, best_gain

# Datos: [Horas_estudio, Simulacros] -> Aprobado (1) / Reprobado (0)
X = np.array([[2, 0], [4, 1], [6, 0], [8, 1], [10, 1]])
y = np.array([0, 0, 1, 1, 1])

feat, thresh, gain = best_split(X, y)
print(f"Mejor división: Feature {feat} <= {thresh} (Ganancia Gini: {gain:.4f})")
# 2. Árbol de Decisión con Scikit-Learn y visualización de reglas
from sklearn.tree import DecisionTreeClassifier, export_text
import numpy as np

# Datos: [Área m2, Habitaciones, Antigüedad años] -> Alto valor (1) / Estándar (0)
X = np.array([
    [45, 1, 15], [60, 2, 8], [95, 3, 2],
    [120, 3, 1], [40, 1, 25], [110, 4, 3]
])
y = np.array([0, 0, 1, 1, 0, 1])

# Controlamos el sobreajuste con max_depth
clf = DecisionTreeClassifier(criterion='gini', max_depth=3, random_state=42)
clf.fit(X, y)

print("--- REGLAS DE DECISIÓN FORMAL DEL ÁRBOL ---")
tree_rules = export_text(clf, feature_names=['Área_m2', 'Habitaciones', 'Antigüedad'])
print(tree_rules)