HuatuCodeHuatuCode

Aprende con esta sección que diseñé

Utiliza la barra del buscador para que puedas encontrar la lección o el tema que quieras.

7 lecciones encontradas
¡Explicándote la Regresión Lineal!
Machine Learning Principiante5 min de lectura

¡Explicándote la Regresión Lineal!

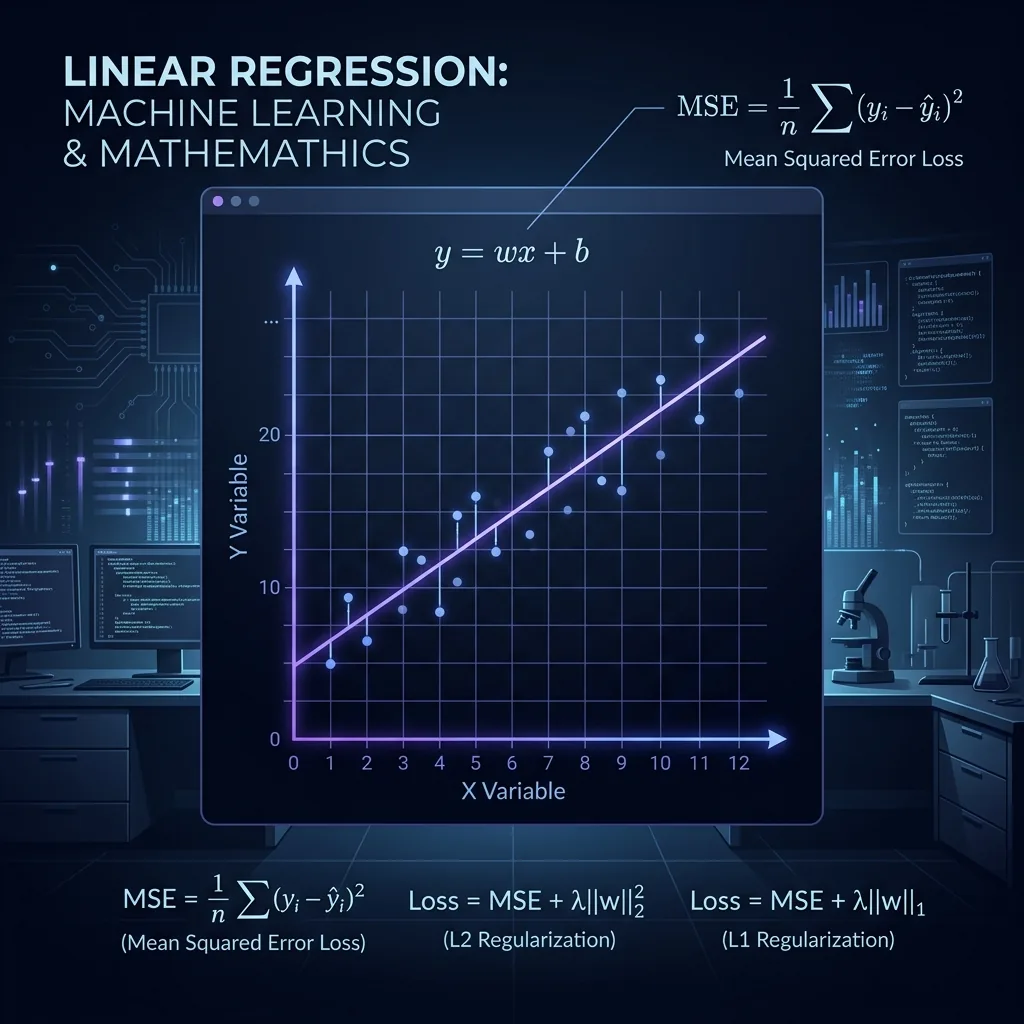
Comprende la intuición geométrica de la recta de mejor ajuste, la función de costo (MSE), la optimización de pesos y la regularización L1 / L2 sin cajas negras.

  • ›Intuición visual de la pendiente (m) e intercepto (b)
  • ›Cálculo del Error Cuadrático Medio (MSE) paso a paso
  • ›Regularización Ridge (L2) vs Lasso (L1) para evitar sobreajuste
  • ›Conexión directa con nuestro simulador de precios inmobiliarios
#Regresión#MSE#L1 Lasso#L2 Ridge#Álgebra Lineal
¡Explicando la Regresión Logística!
Machine Learning Principiante5 min de lectura

¡Explicando la Regresión Logística!

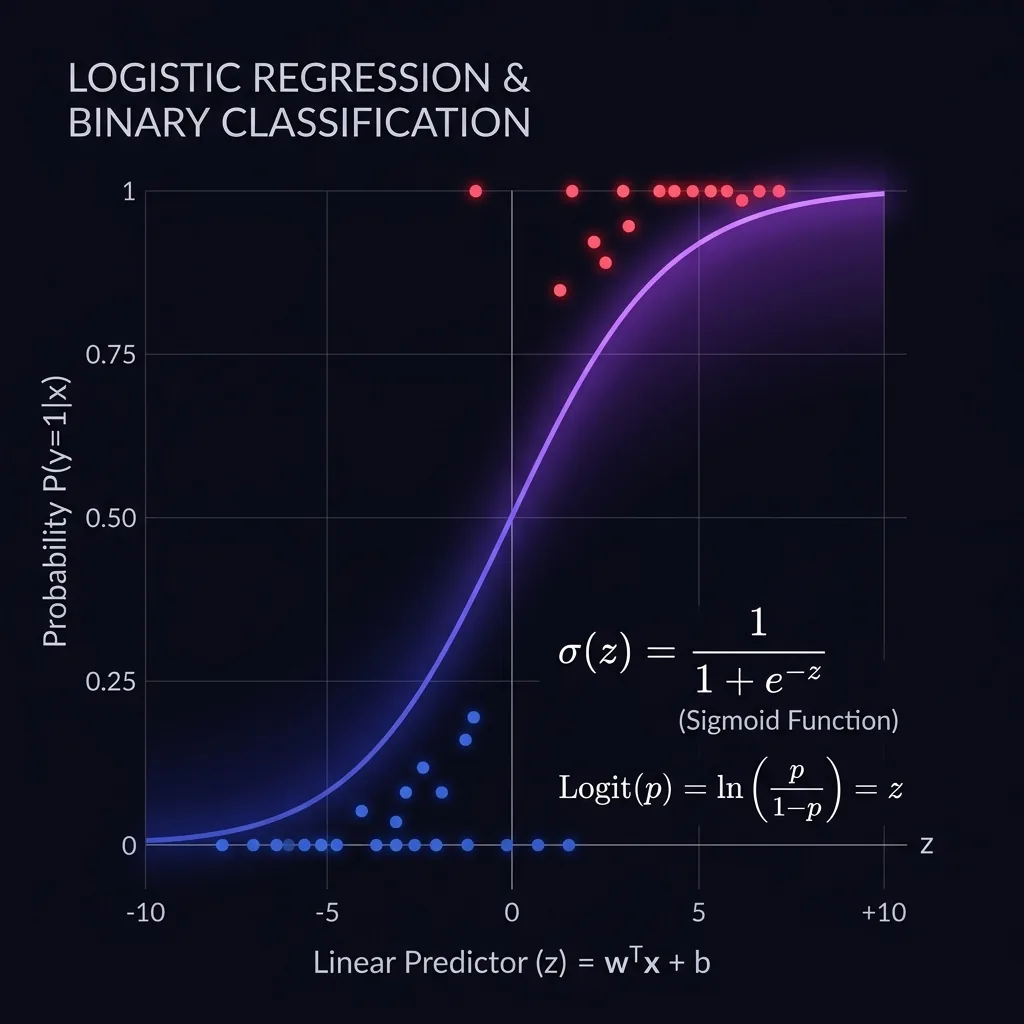
De valores continuos a probabilidades binarias: cómo la función Sigmoide comprime cualquier número real entre 0 y 1 para tomar decisiones de clasificación.

  • ›Por qué una recta simple falla estrepitosamente al clasificar categorías
  • ›La función Sigmoide σ(z) explicada geométricamente
  • ›La función de pérdida Log-Loss (Binary Cross-Entropy)
  • ›Umbral de decisión (Decision Threshold) y probabilidades
#Clasificación#Sigmoide#Probabilidad#Log-Loss#Odds Ratio
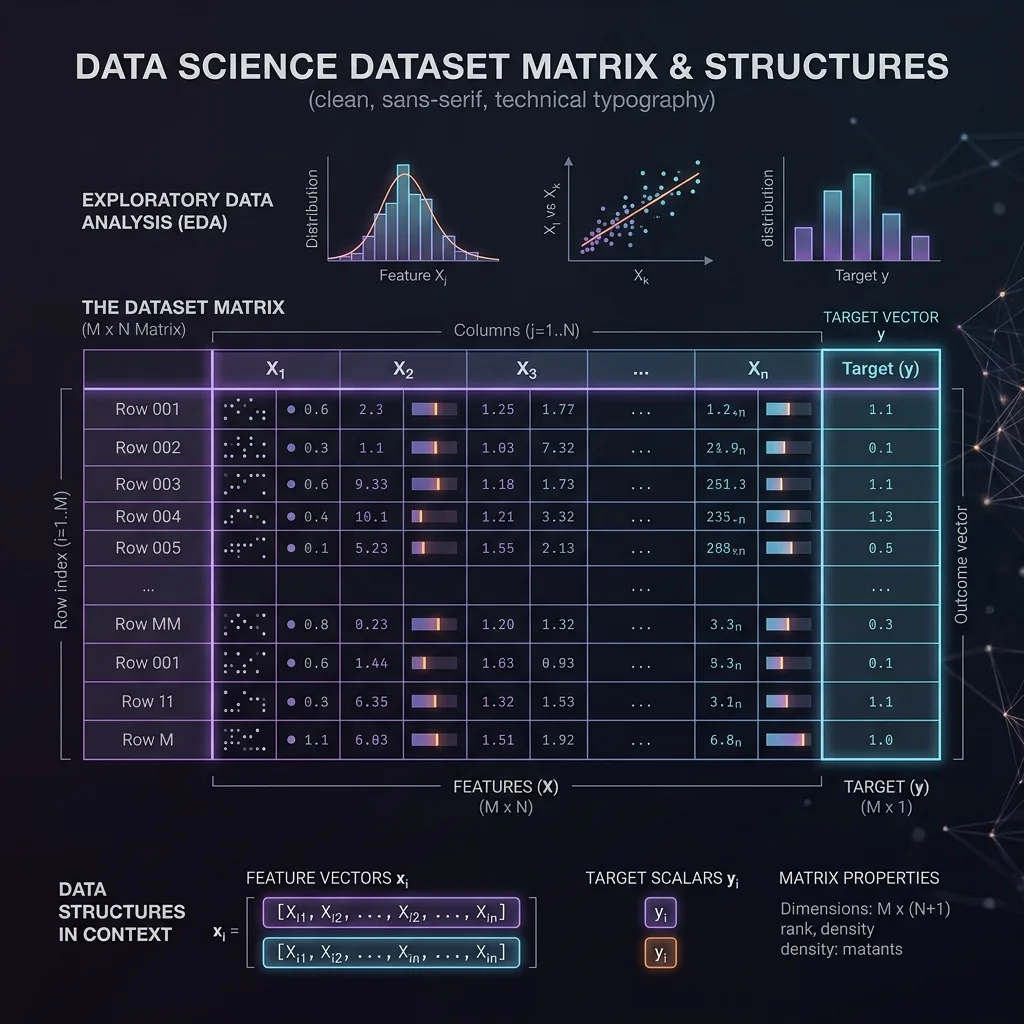
¿Qué es un Dataset?
Data Science Principiante4 min de lectura

¿Qué es un Dataset?

La materia prima de todo sistema inteligente. Analizamos filas (muestras), columnas (features), la matriz X, el vector objetivo y y por qué los datos limpios importan más que los algoritmos complejos.

  • ›Anatomía de una matriz de datos: Instancias (filas) vs Características (columnas)
  • ›Diferencia entre variables numéricas, categóricas y temporales
  • ›La regla inquebrantable del 'Garbage In, Garbage Out' en Machine Learning
  • ›Cómo cargar y auditar un dataset en Python con Pandas
#Dataset#Matriz X#Vector y#EDA#Limpieza de Datos
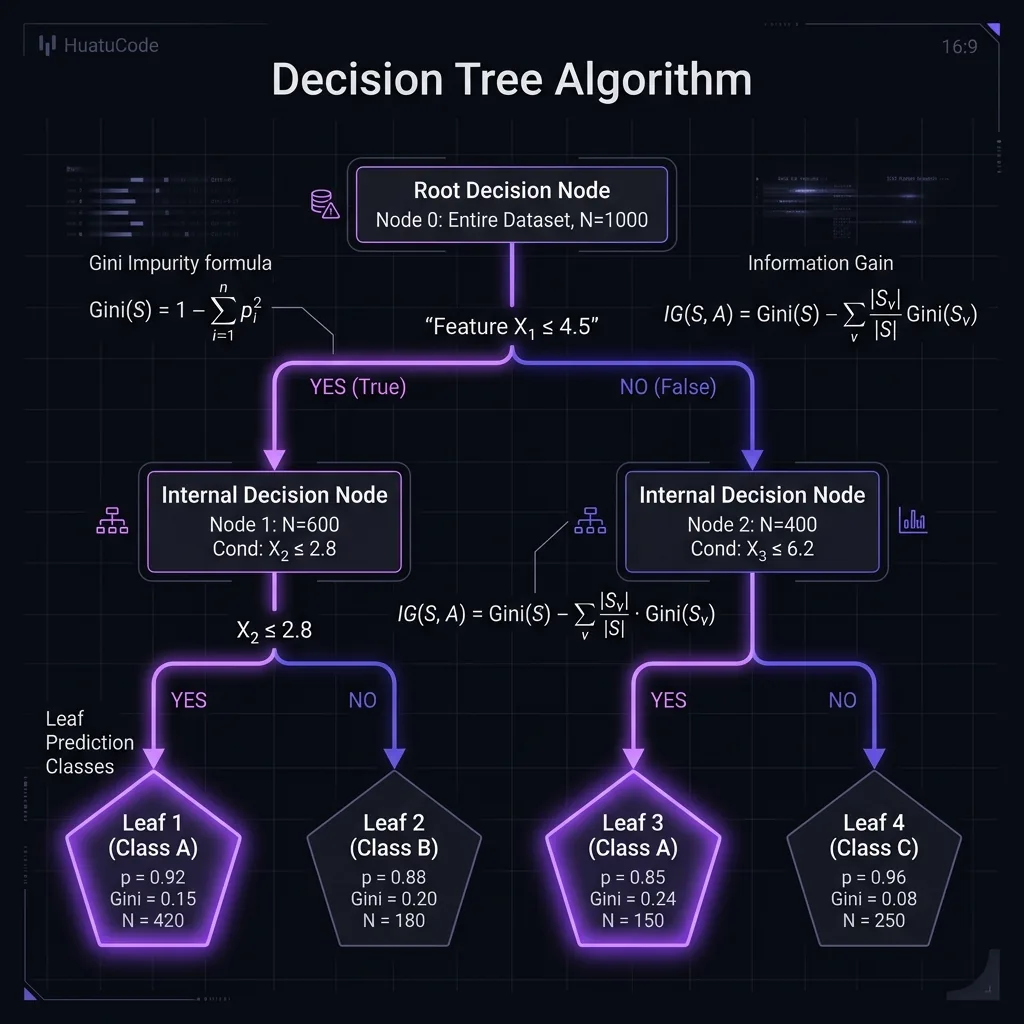
Árboles de Decisión: De Preguntas Simples a Divisiones Matemáticas
Machine Learning Principiante6 min de lectura

Árboles de Decisión: De Preguntas Simples a Divisiones Matemáticas

Aprende cómo un algoritmo divide el espacio de datos en ramas lógicas usando la impureza de Gini y la ganancia de información (Information Gain) para clasificar y predecir.

  • ›Cómo se eligen las preguntas óptimas en cada nodo
  • ›Cálculo de la Impureza de Gini paso a paso
  • ›El riesgo del sobreajuste y control de profundidad (max_depth)
  • ›Implementación con Scikit-Learn y visualización
#Árboles#Gini#Entropía#Information Gain#Partición
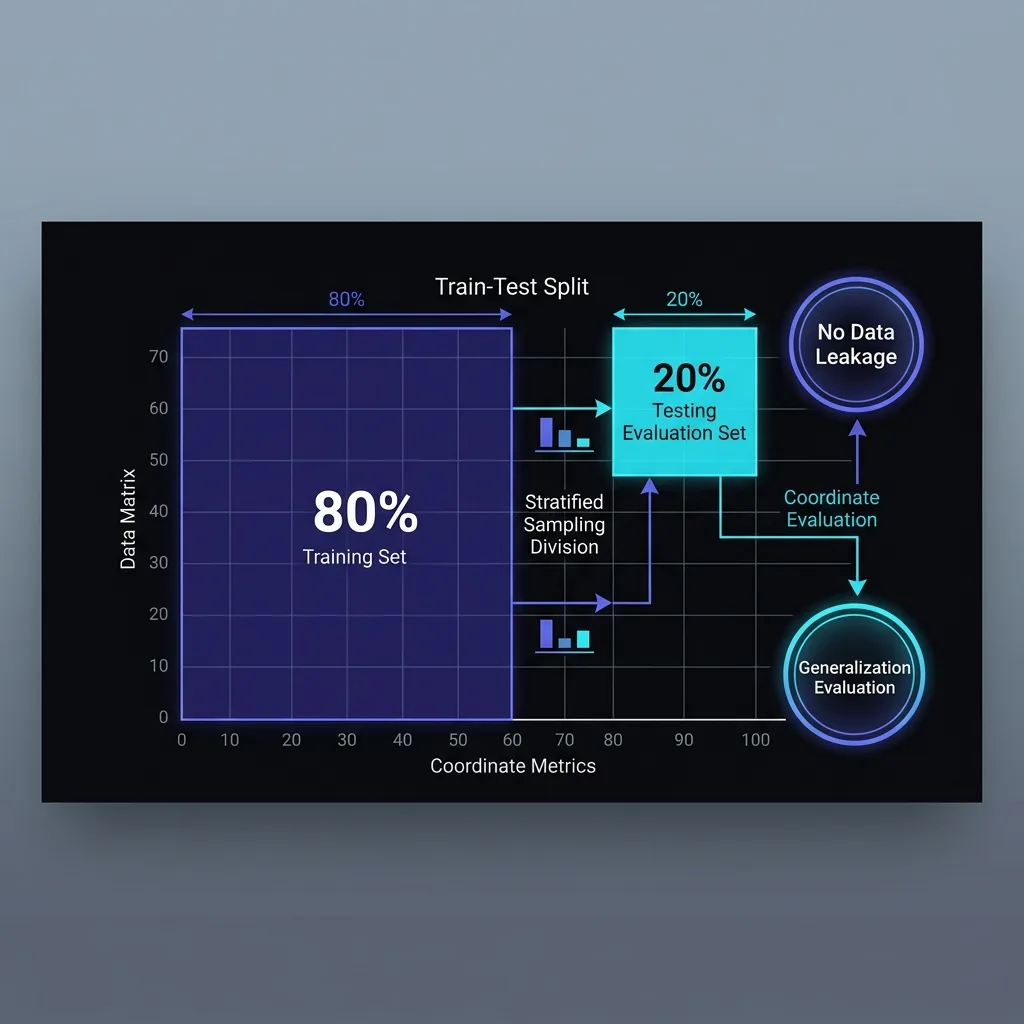
Train-Test Split: La Regla Inquebrantable de la Validación
Data Science Principiante5 min de lectura

Train-Test Split: La Regla Inquebrantable de la Validación

¿Por qué evaluar tu modelo en los mismos datos de entrenamiento es trampa? Aprende a dividir tus datos correctamente, evitar el Data Leakage y usar muestreo estratificado.

  • ›Por qué memorizar no es lo mismo que generalizar
  • ›El porcentaje ideal: 80/20, 70/30 y el rol de random_state
  • ›Muestreo estratificado (stratify) para clases desbalanceadas
  • ›Diferencia crucial entre Test Set y Validación Cruzada (K-Fold)
#Train-Test#Validación#Data Leakage#Estratificación#Overfitting
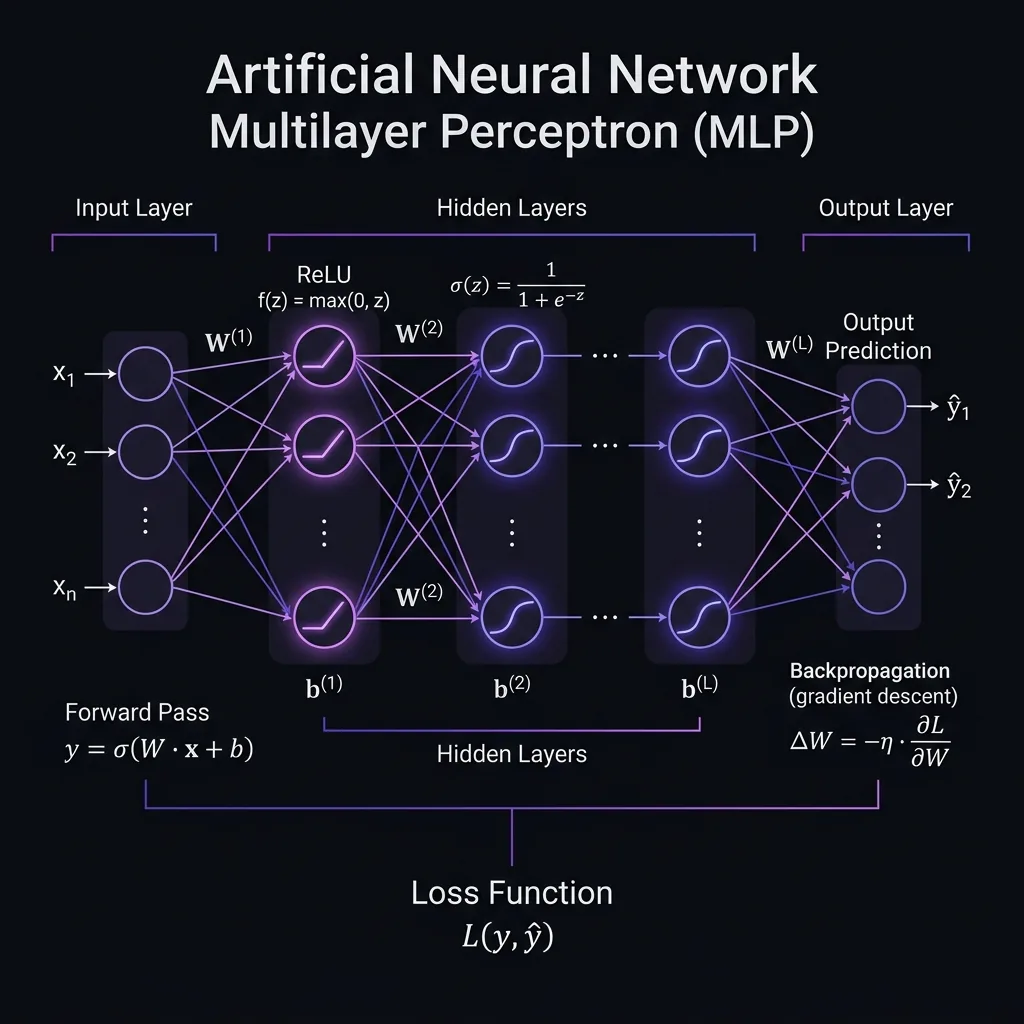
Redes Neuronales: De la Neurona al Perceptrón Multicapa (MLP)
Ciencias de la Computación Intermedio7 min de lectura

Redes Neuronales: De la Neurona al Perceptrón Multicapa (MLP)

Comprende la arquitectura del Deep Learning: cómo se conectan capas de neuronas artificiales mediante matrices de pesos, sesgos (bias), funciones no lineales y Backpropagation.

  • ›La fórmula de una neurona: y = f(w·x + b)
  • ›Por qué necesitamos activación no lineal (ReLU / Sigmoide)
  • ›El viaje completo: Forward Propagation vs Backpropagation
  • ›Implementación de una red MLP con NumPy y Scikit-Learn
#Deep Learning#Perceptrón#MLP#Backpropagation#ReLU
Random Forest: La Sabiduría de las Multitudes en Machine Learning
Machine Learning Intermedio6 min de lectura

Random Forest: La Sabiduría de las Multitudes en Machine Learning

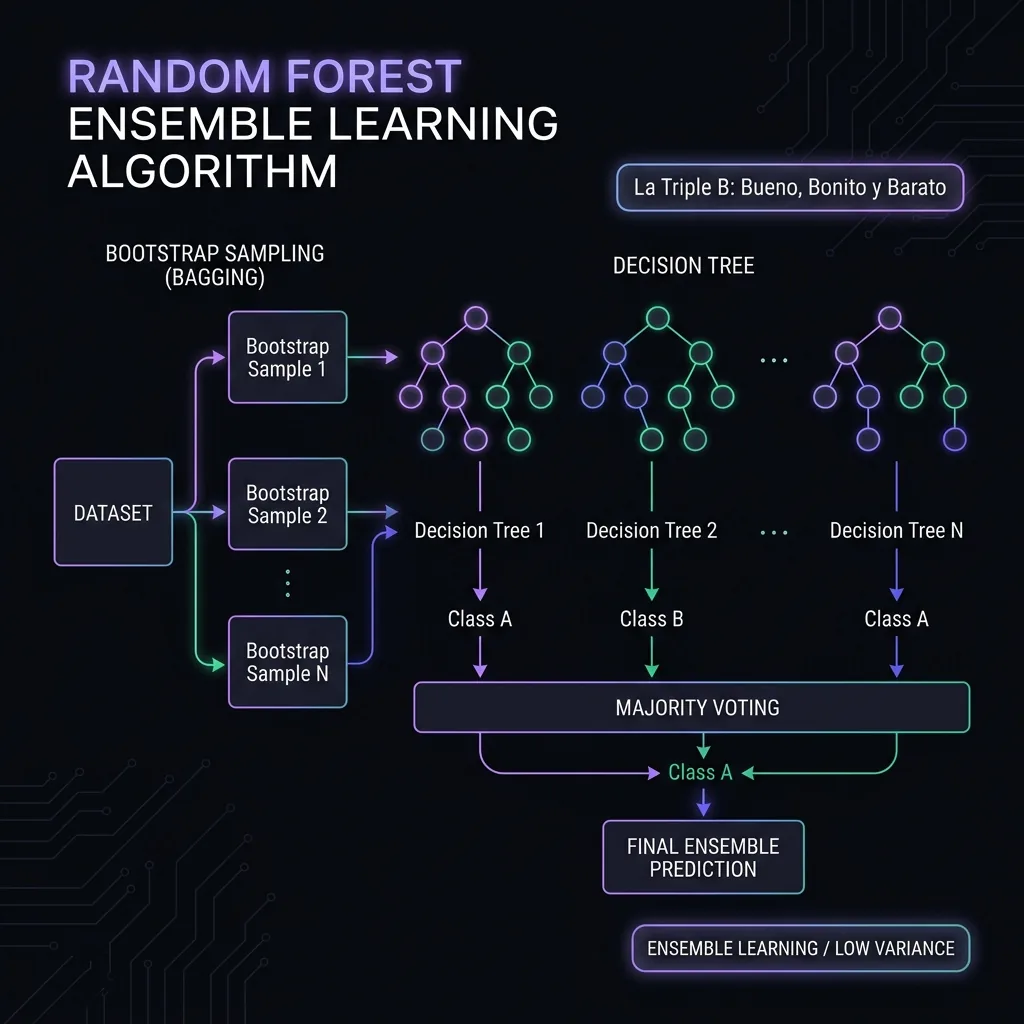
El algoritmo de la 'Triple B' (Bueno, Bonito y Barato). Descubre por qué promediar decenas de árboles de decisión independientes con Bagging supera a casi cualquier modelo individual sin sobreajustar.

  • ›Por qué es la 'Triple B': Bueno, Bonito y Barato para datos tabulares
  • ›Ensamble por Bagging (Bootstrap Aggregation) explicado
  • ›Decorrelación de árboles: selección aleatoria de características
  • ›Error Out-of-Bag (OOB) e importancia de variables (Feature Importance)
#Random Forest#Ensembles#Bagging#Triple B#Kaggle Standard