
¿Qué es un Dataset?
La materia prima de todo sistema inteligente. Analizamos filas (muestras), columnas (features), la matriz X, el vector objetivo y y por qué los datos limpios importan más que los algoritmos complejos.
01La Materia Prima de la Inteligencia Artificial
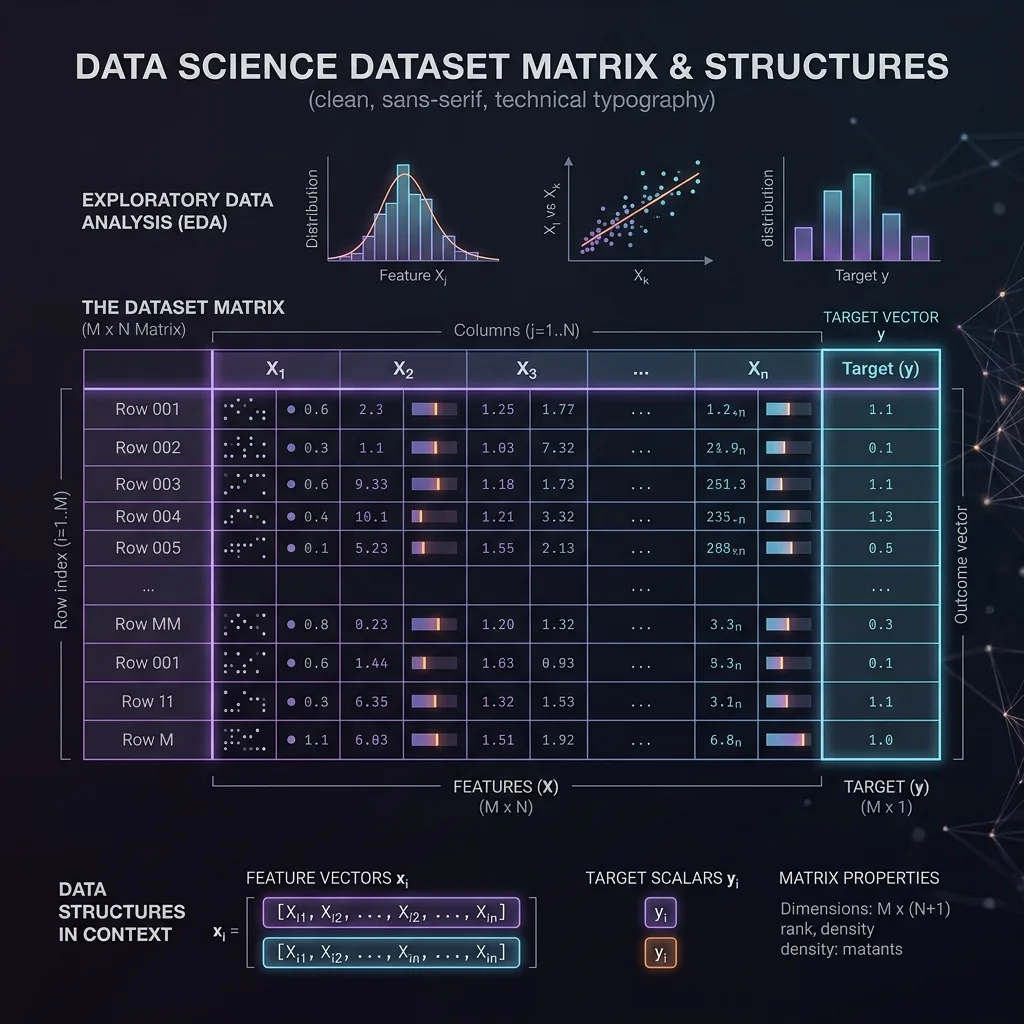
Un Dataset no es simplemente un archivo Excel o CSV; matemáticamente es una Matriz de Datos donde cada fila representa una observación del mundo real y cada columna representa una variable cuantificable.
En Machine Learning existe una regla de oro inquebrantable: "Garbage In, Garbage Out". Un modelo complejo con algoritmos de última generación fracasará si el dataset tiene datos ruidosos, duplicados o mal codificados.
02Anatomía de la Matriz: Features (X) y Target (y)
Matriz de Características (X)
Es una matriz bidimensional de dimensión M × N (donde M es el número de muestras y N es el número de variables descriptivas como metros cuadrados, antigüedad o habitaciones).
Vector Objetivo (y)
Es el vector unidimensional de longitud M que contiene lo que queremos aprender a predecir (ej. el precio de venta en USD o si un cliente renovará un contrato).
03Tipos de Variables que Encontrarás
Continuas (ej. 78.5 m²) o Discretas (ej. 3 dormitorios). Alimentan directamente ecuaciones lineales.
Nominales (ej. "Miraflores", "Surco") u Ordinales (ej. "Bajo", "Medio", "Alto"). Requieren One-Hot Encoding.
Fechas y marcas de tiempo (ej. 2024-03-15). Clave para series de tiempo y partición temporal.
04Valores Faltantes (NaN), Outliers y Escalado de Datos
Ningún dataset del mundo real llega listo para ser consumido por un algoritmo. El 80% del tiempo de un científico de datos se dedica a la higiene y preparación matemática de las matrices:
Centra en media 0 y varianza unitaria 1. Esencial para modelos basados en gradientes (Regresión, Redes Neuronales) y distancias (KNN, SVM).
Comprime todo al intervalo estricto [0, 1]. Obligatorio para intensidades de píxeles en imágenes o algoritmos que no admiten valores negativos.
Utiliza la mediana y el rango intercuartílico. Es inmune a valores atípicos (outliers) extremos en datasets financieros y transaccionales.
05¿En qué situaciones conviene cada estrategia de preprocesamiento?
No existe una receta universal de preprocesamiento; la elección depende estrictamente del algoritmo consumidor y de la naturaleza estadística del dominio.
- Presencia de Outliers Extremos (Finanzas):
Conviene
RobustScalero transformación logarítmicanp.log1p(x). Si usarasStandardScaleren ingresos o transacciones millonarias, la media se desviaría y aplastaría al 99% de las instancias normales cerca de cero. - Imputación por Mediana vs KNN Imputer:
Usa mediana o moda cuando los datos faltantes sean escasos (< 5%) y busques velocidad. Usa KNN Imputer cuando las variables correlacionadas contengan pistas ricas para deducir el valor faltante con precisión.
- El Paradigma "Data-Centric AI":
En la industria moderna de Machine Learning, es mucho más rentable invertir 3 días depurando, etiquetando y eliminando duplicados en 1,000 filas que gastar semanas afinando hiperparámetros en 50,000 filas con ruido ("Garbage In, Garbage Out").
- Escalar datos para modelos de Árboles (Random Forest / XGBoost):
Los algoritmos basados en árboles buscan umbrales de partición
X_i ≤ umbral; son completamente invariantes a transformaciones monótonas de escala. Escalar sus variables no altera en nada la división y añade cómputo inútil. - One-Hot Encoding en Categóricas de Alta Cardinalidad:
Si tienes una columna con 5,000 códigos postales o IDs de producto, One-Hot creará 5,000 columnas dispersas consumiendo gigabytes de memoria y diluyendo la información. Conviene Target Encoding o embeddings.
- Eliminar filas con NaN a ciegas (dropna):
Si eliminas todas las filas con algún valor nulo en un dataset con 40 columnas, podrías perder el 70% de tus datos útiles. Solo elimina filas si la variable objetivo está vacía o el registro tiene más del 50% de atributos perdidos.
06Código para Auditar un Dataset en Python con Pandas
# 1. Anatomía y Auditoría de un Dataset en Pandas
import pandas as pd
import numpy as np

# Creamos un dataset estructurado representativo
data = {
    'area_m2': [45, 68, 95, 120, 180],
    'habitaciones': [1, 2, 3, 3, 4],
    'distrito': ['Lince', 'Jesús María', 'Surco', 'San Isidro', 'Miraflores'],
    'precio_usd': [95000, 145000, 210000, 310000, 450000] # Variable Objetivo (y)
}

df = pd.DataFrame(data)

# Separamos Matriz de Features (X) y Vector Objetivo (y)
X = df.drop(columns=['precio_usd'])
y = df['precio_usd']

print("--- DIMENSIONES DE LA MATRIZ DE DATOS ---")
print(f"Instancias (filas): {X.shape[0]}")
print(f"Características (columnas): {X.shape[1]}")

print("\n--- AUDITORÍA DE TIPOS DE VARIABLE ---")
print(X.dtypes)

print("\n--- RESUMEN ESTADÍSTICO INICIAL (EDA) ---")
print(X.describe())