
Random Forest: La Sabiduría de las Multitudes en Machine Learning
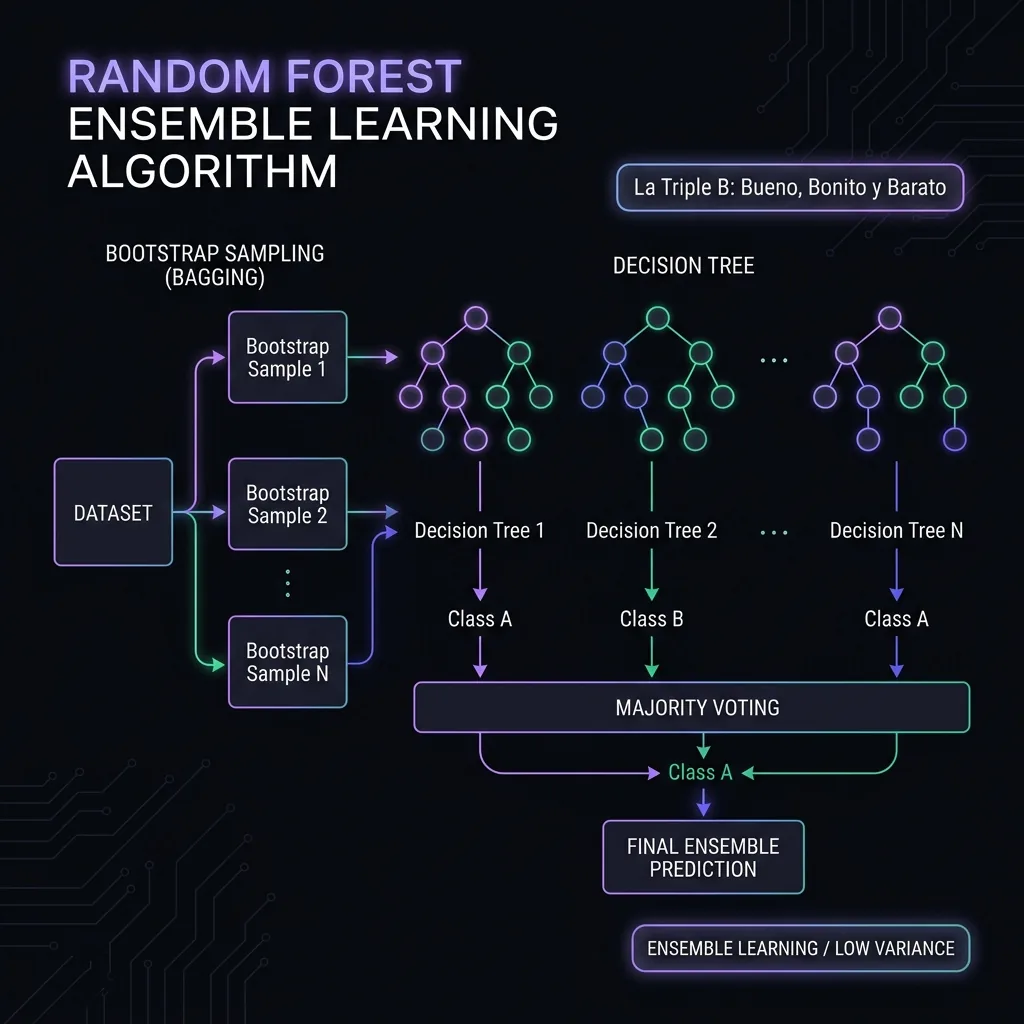
El algoritmo de la 'Triple B' (Bueno, Bonito y Barato). Descubre por qué promediar decenas de árboles de decisión independientes con Bagging supera a casi cualquier modelo individual sin sobreajustar.
¿Quieres ver a 300 árboles votar el precio de un departamento?
Pon a prueba un Random Forest entrenado con datos de Lima, con explicación SHAP de cada predicción e intervalos de confianza.
Random Forest: El Algoritmo de la "Triple B" (Bueno, Bonito y Barato)
En la práctica profesional de Ciencia de Datos y competencias de Kaggle, Random Forest es casi unánimemente el primer modelo de referencia que implementamos en datos tabulares porque cumple a cabalidad con la Triple B:
Reduce drásticamente la varianza de los árboles individuales. A diferencia de casi cualquier otro modelo, no sobreajusta al aumentar el número de árboles (n_estimators).
Es noble con tus datos: no requiere escalado previo (Z-score ni MinMax), tolera valores atípicos y te entrega gratis la importancia de cada variable (feature_importances_).
Se paraleliza de forma trivial en todos los núcleos de tu CPU con n_jobs=-1 y casi sin afinar hiperparámetros supera a redes neuronales complejas en datasets estructurados.
01La Sabiduría de las Multitudes: ¿Cómo Funciona Bagging?
Un solo árbol de decisión es un estimador con alto sesgo hacia sus datos locales y altísima varianza: si cambias unas pocas filas, el árbol entero puede ramificarse de forma radicalmente distinta.
Random Forest soluciona esto mediante el principio de Bagging (Bootstrap Aggregating): crea un comité de decenas o cientos de árboles entrenados con subconjuntos aleatorios creados con reemplazo (bootstrap). Al momento de predecir, promedia todas sus opiniones (regresión) o toma la votación por mayoría simple (clasificación).
02El Toque Maestro de Breiman: Decorrelación de Características
Si simplemente hiciéramos Bagging sobre árboles estándar, todos los árboles elegirían la variable más fuerte en su nodo raíz y terminarían pareciéndose demasiado entre sí (árboles correlacionados).
Leo Breiman introdujo el elemento que hace "Random" al bosque: en cada división de cada árbol, el algoritmo solo evalúa un subconjunto aleatorio de m = √p características (donde $p$ es el número total de columnas). Esto fuerza a los árboles a explorar variables secundarias, descorrelacionándolos y multiplicando el poder predictivo del ensamble.
03Evaluación Gratuita: Error Out-of-Bag (OOB)
Matemáticamente, cuando generas una muestra bootstrap con reemplazo, aproximadamente el 36.8% de las filas del dataset quedan fuera de cada árbol particular.
Estas muestras no vistas se denominan observaciones Out-of-Bag (OOB). Random Forest las utiliza para calcular un puntaje de validación cruzada automático sin que tengas que gastar tiempo o datos separando un set de validación adicional.
04Importancia de Variables (Feature Importance) e Hiperparámetros Clave
Una de las mayores ventajas de Random Forest es que ofrece explicabilidad cuantitativa inmediata a través de la métrica MDI (Mean Decrease in Impurity): calcula cuánto reduce la impureza de Gini cada variable en promedio a lo largo de todos los árboles del bosque.
Más árboles reducen la varianza. A diferencia de las redes, Random Forest no sobreajusta al aumentar este número.
El número de columnas sorteadas en cada división. Es la clave para descorrelacionar los árboles.
Entrena árboles de forma simultánea en todos los núcleos de tu CPU a costo cero.
05¿En qué situaciones conviene utilizar Random Forest?
Random Forest es el verdadero rey de los modelos iniciales en datos estructurados. Su resistencia a fallar lo convierte en la mejor primera opción para cualquier proyecto tabular.
- Línea base obligatoria en datos tabulares:
Siempre debe ser el primer algoritmo que pruebes ante cualquier dataset estructurado (riesgo crediticio, churn de telecomunicaciones, detección de fraude, medicina diagnóstica o tasación inmobiliaria).
- Datasets con valores atípicos y variables heterogéneas:
Es completamente indiferente a escalas (no requiere Z-score ni MinMaxScaler), tolera variables con distribuciones asimétricas y maneja datos faltantes mejor que la mayoría.
- Prioridad en robustez sin pasar horas afinando hiperparámetros:
Con los hiperparámetros por defecto de Scikit-Learn (100 árboles y
max_features='sqrt') suele alcanzar el 95% del rendimiento óptimo teórico sin esfuerzo manual.
- Latencias ultra-bajas en sistemas embebidos (< 1 ms):
Evaluar 200 árboles en memoria implica recorrer miles de ramas; para servidores de publicidad o microcontroladores que requieren microsegundos, un modelo lineal con coeficientes fijos es miles de veces más rápido y liviano en RAM.
- Extrapolación de tendencias crecientes:
Al ser un promedio de árboles con particiones de escalones fijos, Random Forest no puede predecir un valor mayor al máximo visto en el set de entrenamiento (no puede extrapolar inflación ni crecimiento continuo en series de tiempo).
- Datos de visión artificial o texto puro no estructurado:
Para imágenes y lenguaje natural, las redes convolucionales y los Transformers son infinitamente superiores.
06Código Reproducible en Python
# 1. Concepto de Bagging (Bootstrap Aggregating) y Votación por Mayoría
import numpy as np

def bootstrap_sample(X, y):
    n_samples = X.shape[0]
    indices = np.random.choice(n_samples, size=n_samples, replace=True)
    return X[indices], y[indices]

# Supongamos las predicciones de 5 árboles independientes para 4 instancias:
tree_predictions = np.array([
    [1, 0, 1, 1], # Árbol 1
    [1, 0, 0, 1], # Árbol 2
    [1, 1, 0, 1], # Árbol 3
    [1, 0, 1, 1], # Árbol 4
    [0, 0, 1, 1]  # Árbol 5
])

# Consenso del Bosque (Votación por Mayoría simple)
majority_votes = (np.mean(tree_predictions, axis=0) >= 0.5).astype(int)
print("Matriz de Votos (5 árboles x 4 muestras):\n", tree_predictions)
print("\nPredicción final consolidada (Sabiduría de las Multitudes):", majority_votes)
# 2. Random Forest: La 'Triple B' (Bueno, Bonito y Barato) en Scikit-Learn
from sklearn.ensemble import RandomForestClassifier
import numpy as np

features = ['m2_area', 'habitaciones', 'antiguedad_anos', 'piso_edificio', 'dist_parque_km']
X = np.array([
    [55, 2, 12, 3, 0.2],
    [90, 3, 3, 8, 0.1],
    [120, 4, 1, 12, 0.05],
    [40, 1, 30, 1, 1.2],
    [75, 2, 8, 5, 0.4]
])
y = np.array([0, 1, 1, 0, 1])

# ¿Por qué es la Triple B?
# 1. BUENO: Reduce drásticamente la varianza y no sobreajusta con n_estimators altos.
# 2. BONITO: Provee feature_importances_ sin requerir escalado de datos (Z-score).
# 3. BARATO: n_jobs=-1 paraleliza en todos los núcleos de tu procesador al instante.
rf = RandomForestClassifier(
    n_estimators=100,
    max_features='sqrt', # Decorrelación aleatoria de árboles
    oob_score=True,       # Validación gratuita Out-of-Bag
    n_jobs=-1,
    random_state=42
)
rf.fit(X, y)

print("--- IMPORTANCIA DE VARIABLES (FEATURE IMPORTANCE) ---")
for name, importance in zip(features, rf.feature_importances_):
    print(f"{name:18s}: {importance * 100:5.2f}%")
print(f"\nEvaluación Out-of-Bag (OOB Score): {rf.oob_score_ * 100:.1f}%")