
Redes Neuronales: De la Neurona al Perceptrón Multicapa (MLP)
Comprende la arquitectura del Deep Learning: cómo se conectan capas de neuronas artificiales mediante matrices de pesos, sesgos (bias), funciones no lineales y Backpropagation.
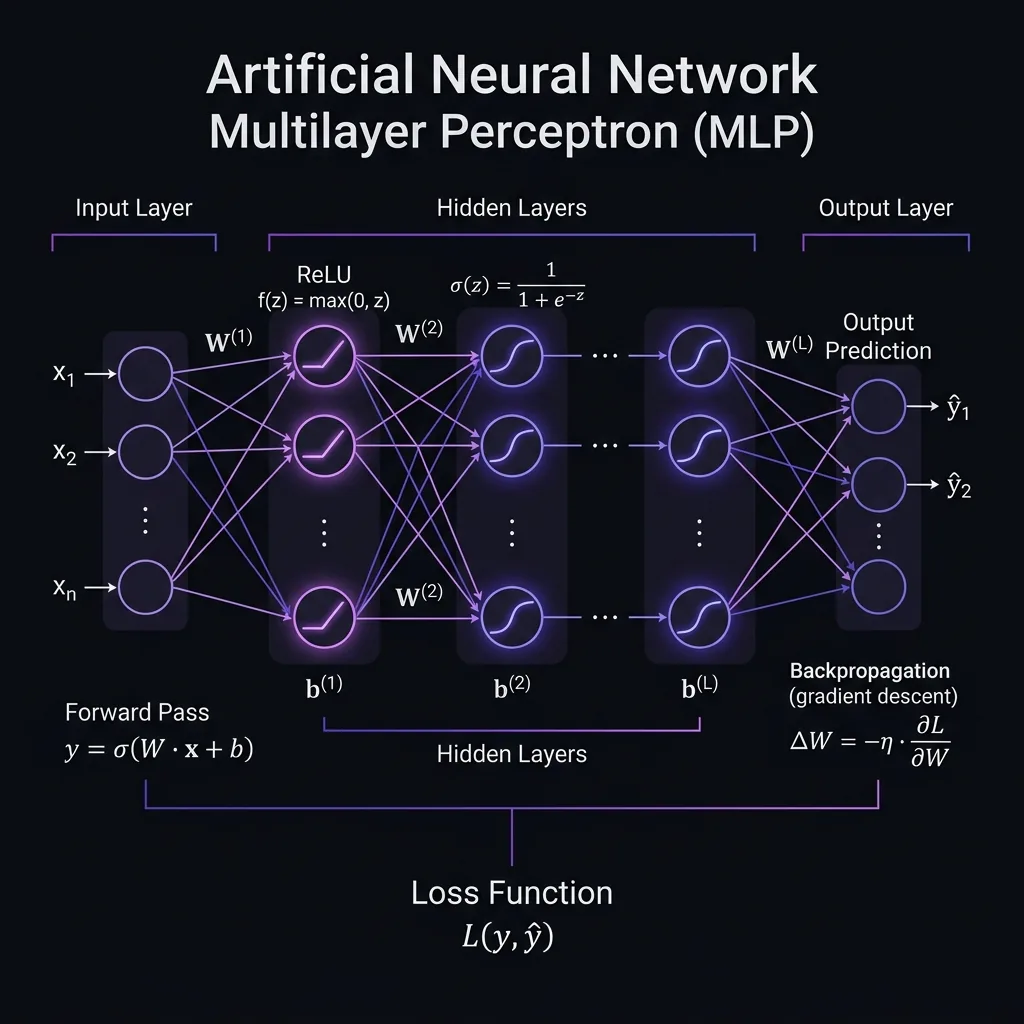
01La Neurona Artificial y el Perceptrón Multicapa (MLP)
Una Red Neuronal Artificial es una función matemática compuesta de múltiples capas de transformaciones lineales intercaladas con activaciones no lineales. En su núcleo, cada neurona individual ejecuta la siguiente ecuación elemental:
Donde w representa los pesos sinápticos que ponderan la relevancia de cada señal, y b es el sesgo (bias) que desplaza la frontera de decisión.
02Por qué Necesitamos Activaciones No Lineales
Sin funciones de activación no lineales entre capas, una red neuronal de 1,000 capas colapsa algebraicamente en una simple regresión lineal: la combinación de matrices lineales consecutivas siempre da como resultado otra matriz lineal única.
Estándar en capas ocultas. Evita gradientes desvanecidos y computa a velocidad récord.
Ideal para la capa de salida en clasificación binaria (retorna probabilidades entre 0 y 1).
Capa de salida multiclase. Garantiza que la suma de todas las probabilidades sea 1.0.
03El Ciclo Completo: Forward Pass y Backpropagation
Propagación hacia Adelante (Forward Propagation)
Los datos ingresan por la capa de entrada, se multiplican por los pesos en las capas ocultas y producen una predicción final con un error cuantificado (Loss).
Retropropagación del Error (Backpropagation)
Mediante la Regla de la Cadena del Cálculo Diferencial, el error viaja hacia atrás capa por capa calculando las derivadas parciales ∂L/∂W para actualizar los pesos en dirección al gradiente descendente.
04Patologías del Entrenamiento: Vanishing Gradient y Dropout
Entrenar redes con millones de parámetros presenta retos matemáticos únicos que no existen en algoritmos lineales:
Desvanecimiento del Gradiente (Vanishing Gradient)
Al usar funciones como Sigmoide o Tanh en redes profundas, multiplicar derivadas < 0.25 repetidamente por la regla de la cadena hace que el gradiente en las primeras capas sea prácticamente 0, impidiendo que la red aprenda. Por eso ReLU es la activación estándar moderna.
Regularización con Dropout
En cada época de entrenamiento, desconecta aleatoriamente un porcentaje (ej. 30%) de neuronas. Esto impide que grupos de neuronas se confabulen memorizando ruido y fuerza a cada neurona a aprender patrones robustos e independientes.
05¿En qué situaciones conviene utilizar Redes Neuronales?
Las Redes Neuronales son aproximadores universales de funciones, pero tienen un coste significativo en datos, infraestructura de GPUs y tiempo de entrenamiento.
- Datos No Estructurados Complejos:
Visión por computadora (detección de objetos, segmentación médica con CNNs), audio/voz y Procesamiento de Lenguaje Natural (LLMs, traducción con Transformers).
- Volúmenes Masivos de Datos:
A diferencia de modelos tradicionales cuyo rendimiento se estanca al superar los 100,000 registros, las redes neuronales profundas continúan mejorando su precisión a medida que se les alimenta con millones de ejemplos.
- Aprendizaje de Representaciones (Embeddings) y Transfer Learning:
Permiten transferir conocimiento de modelos gigantescos previamente entrenados (ej. ResNet, BERT, CLIP) y adaptarlos a tu problema específico con poco cómputo adicional.
- Datasets Tabulares Estructurados (< 50,000 filas):
En datos tabulares (tablas de bases de datos relacionales, hojas de cálculo de clientes o transacciones), Random Forest y Gradient Boosting (XGBoost/LightGBM) superan de forma casi unánime a las redes neuronales, sin requerir GPUs ni semanas de calibración.
- Escasez de Datos de Entrenamiento:
Si tienes menos de 5,000 muestras, una red profunda sobreajustará de inmediato memorizando el ruido particular del set de entrenamiento.
- Restricción de Recursos o Exigencia de Trazabilidad Total:
Si tu infraestructura corre en microprocesadores de bajo consumo o el cliente exige justificar matemáticamente cada decisión nodo por nodo, las redes neuronales son demasiado opacas y costosas.
06Código Reproducible en Python
# 1. Forward Pass de un Perceptrón Multicapa (MLP) en NumPy Puro
import numpy as np

def relu(z):
    return np.maximum(0, z)

def softmax(z):
    exp_z = np.exp(z - np.max(z, axis=1, keepdims=True))
    return exp_z / np.sum(exp_z, axis=1, keepdims=True)

class SimpleMLP:
    def __init__(self, input_dim, hidden_dim, output_dim):
        # Inicialización He/Xavier para estabilidad de gradientes
        self.W1 = np.random.randn(input_dim, hidden_dim) * np.sqrt(2.0 / input_dim)
        self.b1 = np.zeros((1, hidden_dim))
        self.W2 = np.random.randn(hidden_dim, output_dim) * np.sqrt(2.0 / hidden_dim)
        self.b2 = np.zeros((1, output_dim))

    def forward(self, X):
        # Capa Oculta con activación no lineal ReLU: a1 = max(0, X·W1 + b1)
        self.z1 = np.dot(X, self.W1) + self.b1
        self.a1 = relu(self.z1)

        # Capa de Salida con Softmax (distribución de probabilidades)
        self.z2 = np.dot(self.a1, self.W2) + self.b2
        self.probs = softmax(self.z2)
        return self.probs

# 3 muestras con 4 características cada una
X_sample = np.array([[0.5, -0.2, 1.1, 0.8], [1.2, 0.4, -0.9, 0.1], [-0.5, 0.8, 0.3, -1.0]])
model = SimpleMLP(input_dim=4, hidden_dim=8, output_dim=3)
output_probabilities = model.forward(X_sample)
print("Distribución de Probabilidades estimadas por muestra:")
print(np.round(output_probabilities, 3))
# 2. Red Neuronal Multicapa (MLP) en Producción con Scikit-Learn
from sklearn.neural_network import MLPClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
import numpy as np

# Datos simulados con fronteras de decisión no lineales
np.random.seed(42)
X = np.random.randn(200, 6)
y = (X[:, 0] * X[:, 1] + X[:, 2]**2 > 0.8).astype(int)

# Las redes neuronales requieren estandarización previa de datos
mlp_pipeline = make_pipeline(
    StandardScaler(),
    MLPClassifier(
        hidden_layer_sizes=(32, 16),
        activation='relu',
        solver='adam',
        max_iter=500,
        random_state=42
    )
)
mlp_pipeline.fit(X, y)
print(f"Precisión del MLP entrenado: {mlp_pipeline.score(X, y)*100:.2f}%")