
¡Explicándote la Regresión Lineal!
Comprende la intuición geométrica de la recta de mejor ajuste, la función de costo (MSE), la optimización de pesos y la regularización L1 / L2 sin cajas negras.
¿Quieres ver este algoritmo tasando departamentos reales en Lima?
Ponemos a prueba este modelo Ridge con 6 variables, explicabilidad SHAP en tiempo real e intervalos de confianza conformales.
01¿Qué es exactamente la Regresión Lineal?
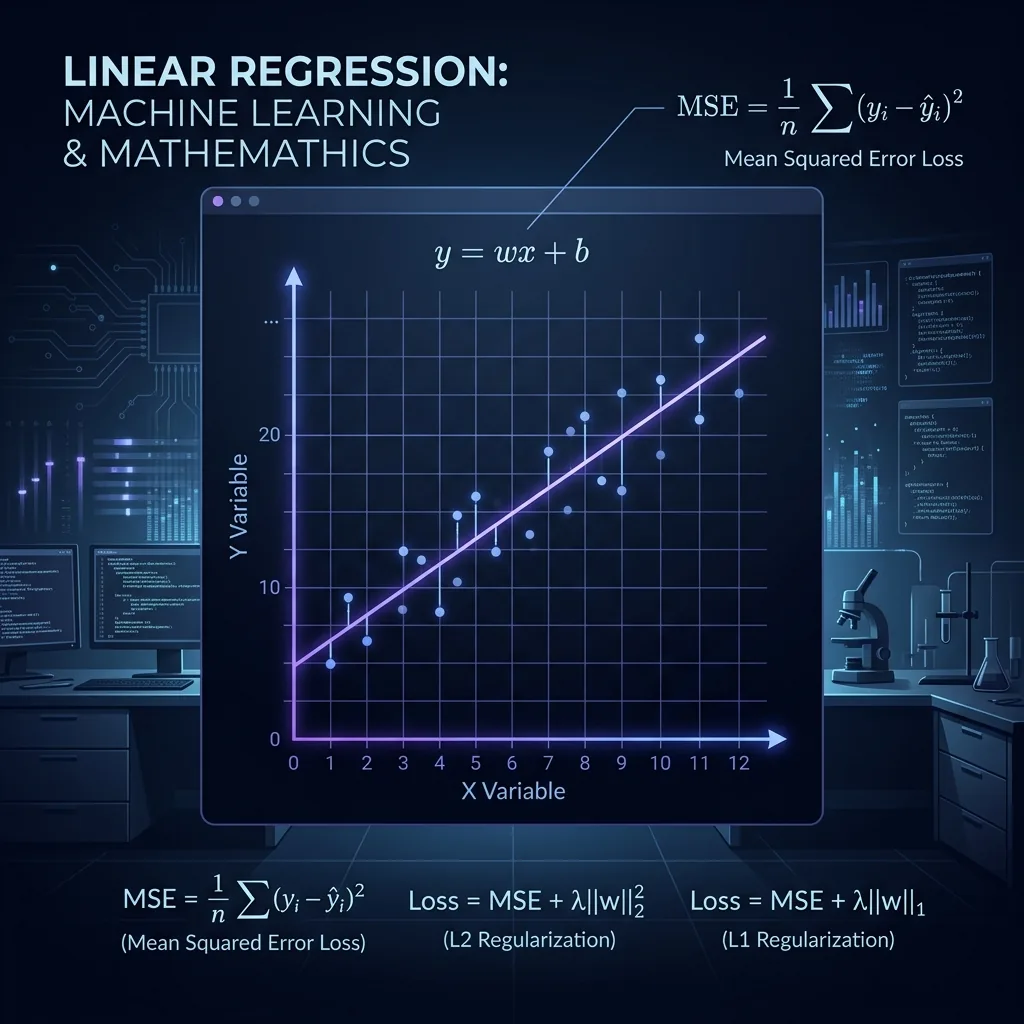
En Ciencias de la Computación y Machine Learning, la Regresión Lineal es el punto de partida fundamental para entender el aprendizaje supervisado. Su objetivo es modelar y predecir una variable continua (como el precio de un departamento, el tiempo de respuesta de un servidor o la temperatura) a partir de una o más variables de entrada (features).
A diferencia de los modelos de "caja negra" que esconden su razonamiento tras millones de parámetros, la regresión lineal es interpretable por diseño: cada coeficiente te dice con precisión matemática cuánto cambia la predicción final por cada unidad que aumenta una característica.
02La Fórmula Fundamental: Pesos (w) y Sesgo (b)
En su versión unidimensional, la ecuación traza la recta clásica de la geometría:
En el mundo real con múltiples variables predictoras, se expande a una combinación lineal multivariable:
Los Pesos (w₁, w₂, ..., wₙ)
Representan la ponderación de cada variable. Si w₁ (área en m²) es positivo y alto, más metros cuadrados elevan fuertemente la tasación.
El Sesgo o Intercepto (b)
Es el valor base esperado cuando todas las variables de entrada son iguales a cero (x = 0). Ancla la recta en el plano.
03¿Cómo aprende el modelo? La Función de Costo (MSE)
Usamos el Error Cuadrático Medio (Mean Squared Error - MSE):
- Evita cancelaciones: Los errores positivos y negativos no se anulan entre sí.
- Penaliza errores grandes: Equivocarse por mucho se castiga de forma exponencial.
- Es diferenciable: Su derivada suave permite optimizar con Gradiente Descendente.
04Regularización: L1 (Lasso), L2 (Ridge) y ElasticNet
Para evitar que los pesos crezcan descontroladamente por ruido o variables correlacionadas (sobreajuste / overfitting), penalizamos la magnitud de los pesos mediante el factor λ (lambda):
Penalización Cuadrática
Encoge pesos suavemente hacia cero sin eliminarlos. Da gran estabilidad numérica.
Penalización Absoluta
Fuerza coeficientes no esenciales a valer cero exactamente (selección automática de features).
Lo Mejor de Ambos
Combina selección de Lasso con estabilidad de Ridge ante grupos de variables correlacionadas.
05¿En qué situaciones conviene utilizar la Regresión Lineal?
La Regresión Lineal no compite con redes neuronales profundas en modelar patrones caóticos; su valor supremo radica en su precisión analítica, bajo costo computacional e interpretabilidad absoluta.
- Relaciones proporcionales continuas:
Fenómenos donde el incremento de una variable produce un cambio proporcional aditivo en el resultado (ej. tasaciones inmobiliarias por m², proyecciones de demanda, ventas según inversión publicitaria o costos fijos y variables).
- Auditoría legal y sectores altamente regulados:
En banca, créditos hipotecarios, seguros y salud, las regulaciones prohíben modelos de caja negra. En regresión lineal, cada coeficiente w te permite justificar ante un juez o auditor exactamente por qué varió una predicción.
- Línea base (Baseline) y latencias de microsegundos:
En sistemas embebidos, IoT o APIs de altísima concurrencia, computar
X · w + btoma microsegundos y consume memoria despreciable sin necesidad de clusters o GPUs caras.
- Relaciones fuertemente no lineales:
Si la relación entre las características y el target es parabólica, exponencial o tiene puntos de quiebre abruptos, una recta producirá un subajuste (Underfitting) severo.
- Datos no estructurados (Imágenes, Audio, Texto libre):
Las interacciones complejas de píxeles o tokens lingüísticos requieren arquitecturas jerárquicas profundas o transformadores.
- Multicolinealidad extrema sin regularizar:
Si dos variables de entrada están prácticamente duplicadas (ej. m² construidos y pies cuadrados), el estimador OLS común se vuelve inestable y distorsiona los pesos sin Ridge o Lasso.
06Código Reproducible en Python
# 1. Implementación de Regresión Lineal con Ridge (L2) desde cero
import numpy as np

class RidgeRegressionFromScratch:
    def __init__(self, lr=0.01, epochs=1000, lambda_reg=0.1):
        self.lr = lr
        self.epochs = epochs
        self.lambda_reg = lambda_reg
        self.weights = None
        self.bias = None

    def fit(self, X, y):
        n_samples, n_features = X.shape
        self.weights = np.zeros(n_features)
        self.bias = 0.0

        for _ in range(self.epochs):
            # Predicción lineal: y_pred = X · w + b
            y_pred = np.dot(X, self.weights) + self.bias

            # Gradientes con penalización L2 (Ridge)
            error = y_pred - y
            dw = (2 / n_samples) * np.dot(X.T, error) + 2 * self.lambda_reg * self.weights
            db = (2 / n_samples) * np.sum(error)

            # Actualización de pesos
            self.weights -= self.lr * dw
            self.bias -= self.lr * db

    def predict(self, X):
        return np.dot(X, self.weights) + self.bias

X_train = np.array([[50, 2], [70, 3], [100, 3], [120, 4]]) # [Área m2, Habitaciones]
y_train = np.array([120000, 160000, 230000, 280000])        # Precios en USD

model = RidgeRegressionFromScratch(lr=0.0001, epochs=5000, lambda_reg=0.05)
model.fit(X_train, y_train)
pred = model.predict(np.array([[85, 2]]))
print(f"Predicción estimada: $ {pred[0]:,.2f} USD")
# 2. Implementación en Producción con Scikit-Learn
from sklearn.linear_model import Ridge, Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
import numpy as np

X = np.array([[45, 1, 1], [68, 2, 2], [95, 3, 2], [180, 3, 3]]) # [Área, Hab, Baños]
y = np.array([95000, 145000, 210000, 420000])

ridge_pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('model', Ridge(alpha=1.0)) # alpha es lambda de penalización
])
ridge_pipeline.fit(X, y)
print(f"Predicción Ridge: $ {ridge_pipeline.predict([[75, 2, 2]])[0]:,.2f} USD")