
¡Explicando la Regresión Logística!
De valores continuos a probabilidades binarias: cómo la función Sigmoide comprime cualquier número real entre 0 y 1 para tomar decisiones de clasificación.
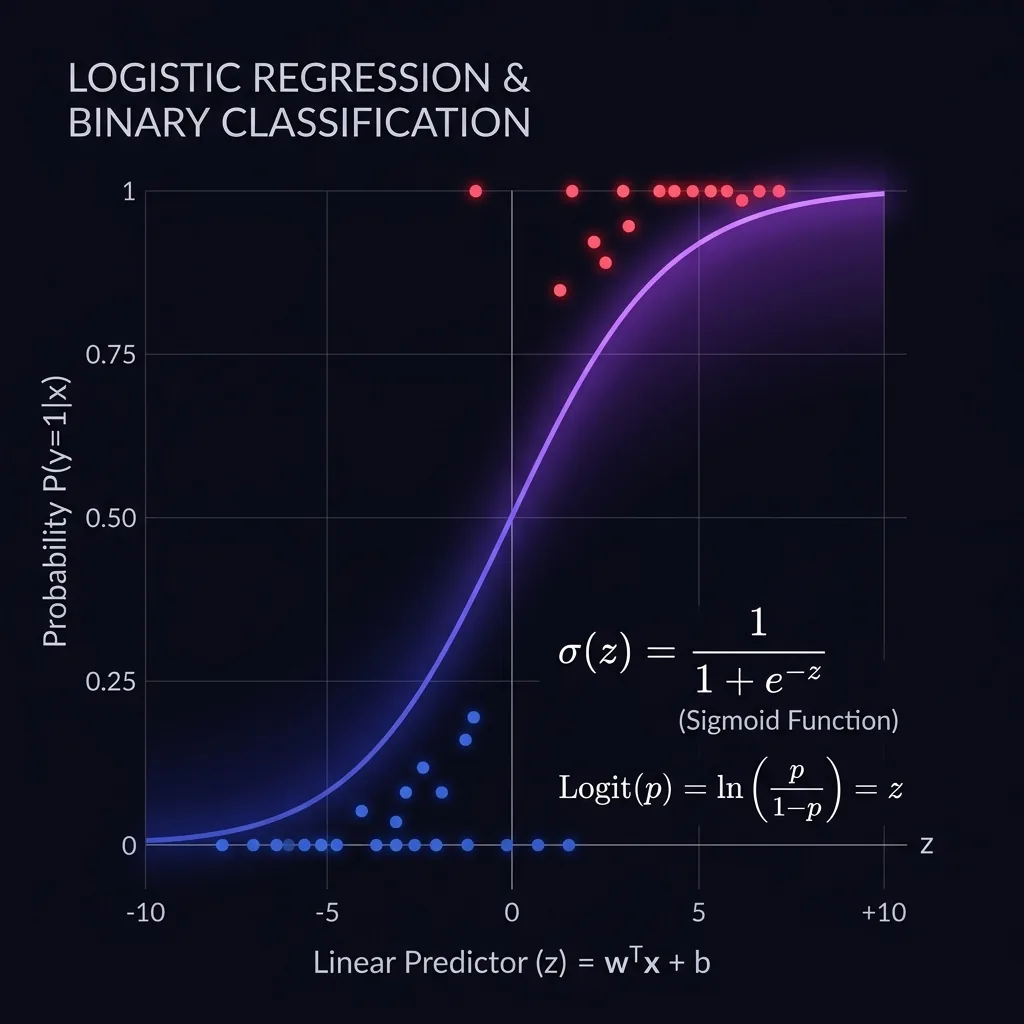
01¿Por qué NO usar Regresión Lineal para Clasificar?
Aunque lleva "Regresión" en su nombre, la Regresión Logística es en realidad un algoritmo de Clasificación.
Si intentaras usar una recta lineal para predecir si un paciente tiene una enfermedad (1) o está sano (0), la recta produciría predicciones absurdas como -0.8 o 2.4. Las probabilidades deben estar estrictamente acotadas entre 0 y 1.
02La Función Sigmoide: De Valores Continuos a Probabilidades
Para comprimir cualquier combinación lineal z = w·x + b al rango (0, 1), aplicamos la Función Sigmoide σ(z):
03Función de Pérdida: Log-Loss (Binary Cross-Entropy)
No podemos usar MSE en clasificación logística porque la función de costo resultante no sería convexa (tendría múltiples mínimos locales). En su lugar, usamos la Pérdida Logarítmica:
Si la clase real es 1 y el modelo predice 0.01, el término -log(0.01) penaliza con un error masivo que fuerza al modelo a corregir sus pesos de inmediato.
04El Umbral de Decisión (Threshold) y Calibración
La función Sigmoide entrega una probabilidad continua P(y = 1 | X) entre 0.0 y 1.0. Para convertir esa probabilidad en una decisión de negocio, fijamos un Umbral de Decisión (Threshold τ):
Umbral Estándar (τ = 0.50)
Se utiliza cuando cometer un Falso Positivo cuesta exactamente lo mismo que un Falso Negativo. Si P > 0.50, se asigna la clase 1.
Umbrales Asimétricos (τ = 0.15 ó τ = 0.85)
En diagnóstico de cáncer o detección de fraude bancario, un Falso Negativo (dejar pasar el caso) es catastrófico; por ello se baja el umbral a τ = 0.15 para capturar todos los casos de riesgo (priorizando Recall).
05¿En qué situaciones conviene utilizar la Regresión Logística?
Es uno de los algoritmos de clasificación más utilizados en la industria financiera y de salud global por su balance perfecto entre capacidad probabilística e interpretabilidad.
- Clasificación con probabilidades calibradas reales:
Cuando el negocio necesita saber la probabilidad exacta de un evento y no solo una etiqueta fría (ej. scoring de riesgo crediticio para bancos: tasa de probabilidad de impago de un préstamo, o cálculo de probabilidad de deserción de clientes / Churn).
- Interpretabilidad mediante Odds Ratio (Razón de Momios):
Permite calcular con exactitud cómo cada variable multiplica las probabilidades de éxito: e^(w_i) indica el factor multiplicativo del riesgo relativo.
- Clasificación de texto y datos dispersos (Sparse Data):
Extraordinariamente eficiente clasificando textos o correos spam combinada con representaciones TF-IDF o Bag-of-Words donde hay miles de palabras pero cada documento tiene pocos términos activos.
- Fronteras de decisión complejas o no lineales:
Si las dos clases forman círculos concéntricos o límites espirales, la regresión logística (que traza un hiperplano lineal de corte) fallará por completo a menos que generes polinomios manuales.
- Interacciones condicionales complejas:
Si la regla de clasificación es del tipo "si A es alto Y B es bajo O C es verdadero", los modelos basados en árboles (Random Forest, XGBoost) capturan esas ramas de decisión de forma nativa mucho mejor.
- Clasificación multiclase masiva con jerarquías:
Si tienes cientos de clases con jerarquías finas (ej. taxonomías botánicas), arquitecturas neuronales con Softmax o clasificadores en ensamble jerárquico superan a estrategias One-vs-Rest logísticas.
06Código Reproducible en Python
# 1. Regresión Logística y Función Sigmoide desde cero
import numpy as np

class LogisticRegressionFromScratch:
    def __init__(self, lr=0.05, epochs=1000):
        self.lr = lr
        self.epochs = epochs
        self.weights = None
        self.bias = None

    def _sigmoid(self, z):
        return 1 / (1 + np.exp(-z))

    def fit(self, X, y):
        n_samples, n_features = X.shape
        self.weights = np.zeros(n_features)
        self.bias = 0.0

        for _ in range(self.epochs):
            # Combinación lineal y activación logística
            z = np.dot(X, self.weights) + self.bias
            y_pred = self._sigmoid(z)

            # Gradientes de la función Log-Loss
            dw = (1 / n_samples) * np.dot(X.T, (y_pred - y))
            db = (1 / n_samples) * np.sum(y_pred - y)

            self.weights -= self.lr * dw
            self.bias -= self.lr * db

    def predict_proba(self, X):
        return self._sigmoid(np.dot(X, self.weights) + self.bias)

    def predict(self, X, threshold=0.5):
        return (self.predict_proba(X) >= threshold).astype(int)

# Datos de juguete: [Horas de estudio, Simulacros previos] -> Aprobó (1) o No (0)
X = np.array([[1, 0], [2, 1], [5, 3], [8, 4], [9, 5]])
y = np.array([0, 0, 1, 1, 1])

clf = LogisticRegressionFromScratch(lr=0.1, epochs=2000)
clf.fit(X, y)
prob = clf.predict_proba(np.array([[6, 2]]))
print(f"Probabilidad de aprobar: {prob[0]*100:.1f}%")
print(f"Clasificación final: {clf.predict(np.array([[6, 2]]))[0]}")
# 2. Clasificación Binaria con Scikit-Learn
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import numpy as np

X = np.array([[10], [20], [30], [50], [60], [80], [90]])
y = np.array([0, 0, 0, 1, 1, 1, 1])

clf = LogisticRegression()
clf.fit(X, y)

print("Probabilidades [P(0), P(1)]:", clf.predict_proba([[45]]))
print("Predicción de clase:", clf.predict([[45]]))