
Train-Test Split: La Regla Inquebrantable de la Validación
¿Por qué evaluar tu modelo en los mismos datos de entrenamiento es trampa? Aprende a dividir tus datos correctamente, evitar el Data Leakage y usar muestreo estratificado.
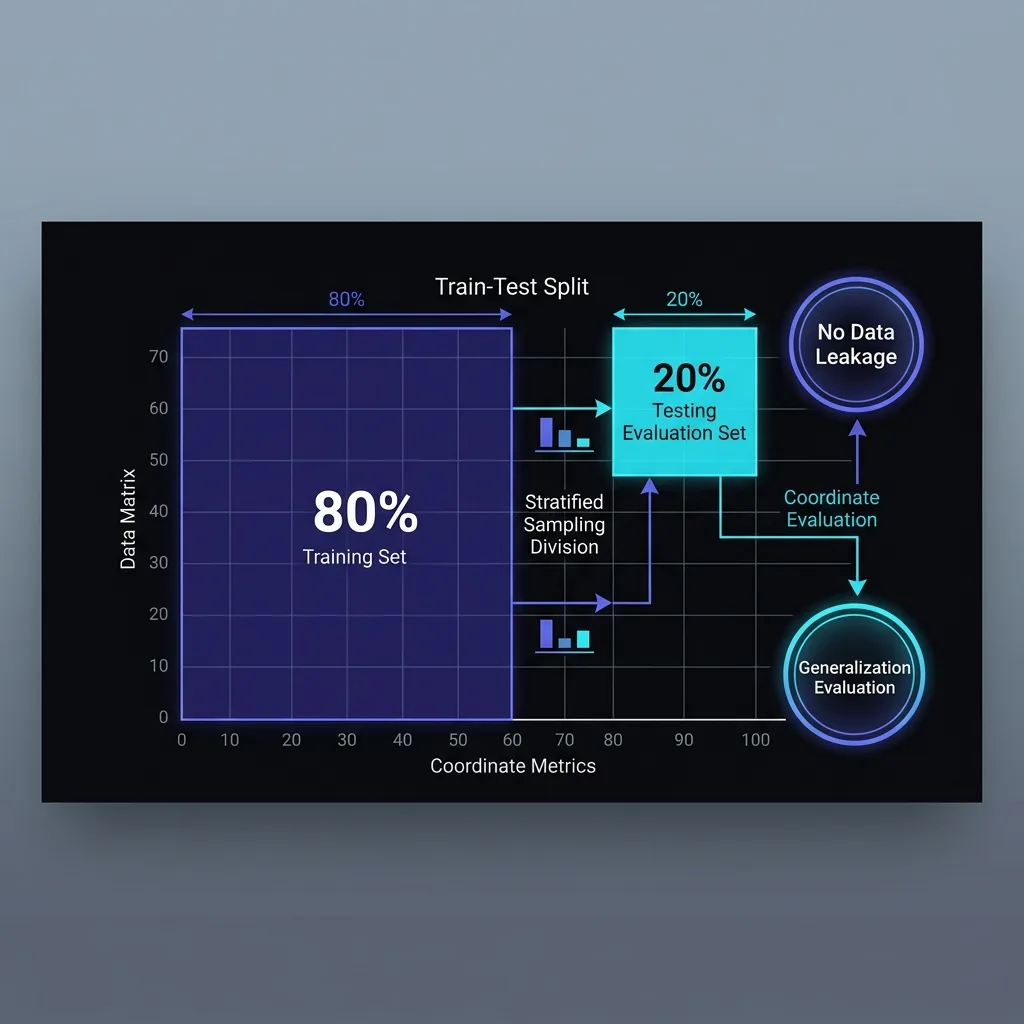
01La Regla Inquebrantable de la Validación Científica
Evaluar un algoritmo de Machine Learning sobre los mismos datos con los que fue entrenado equivale a entregarle a un estudiante el examen resuelto antes de la prueba: obtendrá un 100%, pero no habrá aprendido a resolver problemas nuevos.
El objetivo supremo de cualquier modelo estadístico no es memorizar los datos históricos, sino generalizar con precisión ante observaciones nunca antes vistas. La partición Train-Test Split es la primera línea de defensa contra el sesgo de optimismo y el peligroso Data Leakage (fuga de datos).
02Anatomía de la Partición: 80/20, 70/30 y el rol de random_state
Conjunto de Entrenamiento (80%)
Es el material de estudio exclusivo del algoritmo. Aquí se ajustan los pesos $w$, sesgos $b$ o las divisiones de los nodos.
Conjunto de Prueba / Test (20%)
Permanece sellado en una "bóveda". Solo se expone al modelo al final del ciclo de vida para auditar su verdadero rendimiento en producción.
El parámetro random_state=42 fija la semilla del generador pseudoaleatorio, permitiendo que cualquier colega o evaluador reproduzca la misma partición exacta en su computadora.
03Muestreo Estratificado (Stratified Split)
¿Qué ocurre si estás detectando fraudes con tarjetas donde solo el 1% de las transacciones son fraudulentas?
Una división aleatoria simple podría colocar todas las transacciones fraudulentas en el conjunto de entrenamiento y dejar al conjunto de prueba sin ninguna, destruyendo la validez de la evaluación. Usar stratify=y obliga a Scikit-Learn a conservar la misma proporción de clases (1% fraudes) tanto en Train como en Test.
04El Peligro del Data Leakage y Validación Cruzada (K-Fold)
El error más destructivo en Machine Learning es la Fuga de Datos (Data Leakage): contaminar el conjunto de entrenamiento con información que proviene del conjunto de evaluación.
Si normalizas o calculas la media con todo el dataset ANTES de hacer la partición, el set de entrenamiento ya "conoce" la media de las filas de prueba. El orden inquebrantable debe ser:
05¿En qué situaciones conviene hacer 80/20, 70/30, 75/25 o 90/10?
No existe un porcentaje mágico único. La proporción óptima entre entrenamiento y evaluación depende estrictamente del volumen total de datos, la varianza del problema y la necesidad de ajustar hiperparámetros:
80% Train / 20% TestEl Estándar de Oro de la Industria
Datasets Medianos (1,000 a 50,000 filas)¿En qué situación conviene?: Es la partición por defecto de referencia para la inmensa mayoría de proyectos con volumen moderado.
Por qué funciona: Concede el 80% del volumen a los pesos del modelo para capturar la distribución estadística subyacente, al tiempo que reserva un 20% sellado (entre 200 y 10,000 instancias) que ofrece suficiente significancia estadística para calcular métricas (R², F1-Score, RMSE) con intervalos de confianza estrechos.
70% Train / 30% TestDatasets Pequeños o Alta Varianza
Datasets Escasos (< 1,000 filas)¿En qué situación conviene?: Cuando los datos son muy costosos de recolectar (ensayos clínicos médicos, muestras biológicas escasas, encuestas reducidas de 200 a 800 pacientes).
Por qué funciona: Si tienes solo 300 filas y dejas un 20% en test, tendrías apenas 60 observaciones de prueba. En 60 filas, fallar o acertar en 2 ó 3 casos por puro azar distorsiona la métrica final de forma errática. Subir el test al 30% (90 a 120 filas) otorga la masa crítica estadística mínima para que la evaluación sea rigurosa.
75% Train-Val / 25% TestPartición de Tres Vías para Tuning
Ajuste Intensivo de Hiperparámetros¿En qué situación conviene?: Cuando vas a iterar decenas de modelos, optimizar regularizaciones o realizar búsquedas en malla (GridSearchCV / Optuna).
Por qué funciona: Permite subdividir el bloque del 75% en un 60% Train puro y un 15% Validation (usado para elegir el mejor modelo y regularización), dejando el 25% final totalmente congelado e intocado hasta el despliegue final como evaluación ciega.
90/10 ó 99/1La Era de Big Data y Deep Learning
Datasets Masivos (> 500,000 a Millones de Filas)¿En qué situación conviene?: Modelos de Computer Vision (ImageNet), procesamiento de lenguaje natural (LLMs) o telemetría de millones de transacciones de usuarios.
Por qué funciona: En un dataset de 2,000,000 de muestras, guardar un 20% para test desperdiciaría 400,000 muestras valiosísimas que la red neuronal necesita para generalizar. Con un 1% o 5% de test (20,000 a 100,000 muestras), ya tienes una precisión estadística con error estándar prácticamente nulo, permitiendo que el 95%-99% de los datos alimente el aprendizaje.
Time-Series Split¡Prohibido mezclar datos al azar en Series Temporales!
Datos con Orden Cronológico¿En qué situación aplica?: Precios de bolsa, demanda eléctrica hora a hora, ventas diarias de retail o métricas de servidores en tiempo real.
La regla inquebrantable: Nunca uses partición aleatoria convencional; introducirías el destructivo Look-Ahead Bias (el modelo entrenaría con datos del jueves para predecir el martes). La partición DEBE ser cronológica: entrenas con el pasado (ej. Enero a Octubre) y evalúas en el futuro (Noviembre a Diciembre).
06Código Reproducible en Python
# 1. Train-Test Split desde cero con permutación aleatoria
import numpy as np

def train_test_split_scratch(X, y, test_size=0.2, random_state=None):
    if random_state is not None:
        np.random.seed(random_state)

    n_samples = len(X)
    n_test = int(n_samples * test_size)

    # Permutación aleatoria de índices para evitar sesgos de orden secuencial
    shuffled_indices = np.random.permutation(n_samples)

    test_indices = shuffled_indices[:n_test]
    train_indices = shuffled_indices[n_test:]

    return X[train_indices], X[test_indices], y[train_indices], y[test_indices]

# Demostración
X = np.array([[i, i*2] for i in range(10)])
y = np.array([0, 0, 0, 0, 0, 1, 1, 1, 1, 1])

X_train, X_test, y_train, y_test = train_test_split_scratch(X, y, test_size=0.3, random_state=42)
print(f"Muestras de Entrenamiento (Train): {len(X_train)}")
print(f"Muestras de Evaluación (Test):     {len(X_test)}")
# 2. Partición Estratificada con Scikit-Learn (Sin Data Leakage)
from sklearn.model_selection import train_test_split
import numpy as np

# Dataset con clases desbalanceadas (Detección de fraude: 90% normales, 10% anomalías)
X = np.random.randn(100, 4)
y = np.array([0]*90 + [1]*10)

# stratify=y preserva la distribución de clases en ambos subconjuntos
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.20,
    stratify=y,
    random_state=42
)

print(f"Proporción de clase 1 en Train: {np.mean(y_train)*100:.1f}%")
print(f"Proporción de clase 1 en Test:  {np.mean(y_test)*100:.1f}%")